
梦核后室
DREAMCORE / BACKROOMS
进入梦境。
六段 10–15 秒的生成片段构成全片。声音与画面同步生成,成片未做额外剪辑,总时长不超过 90 秒。
站内播放器由哔哩哔哩提供;若加载受限,可通过 Bilibili 链接观看。
- 参考输入
- 1 张人物资产 + 1 张设定图
- 片段构成
- 6 段 · 每段 10–15 秒
- 生成方式
- 本地 ComfyUI · MiniMax H3
- 声音制作
- 与视频同步生成
两张图,
一个梦境的起点。
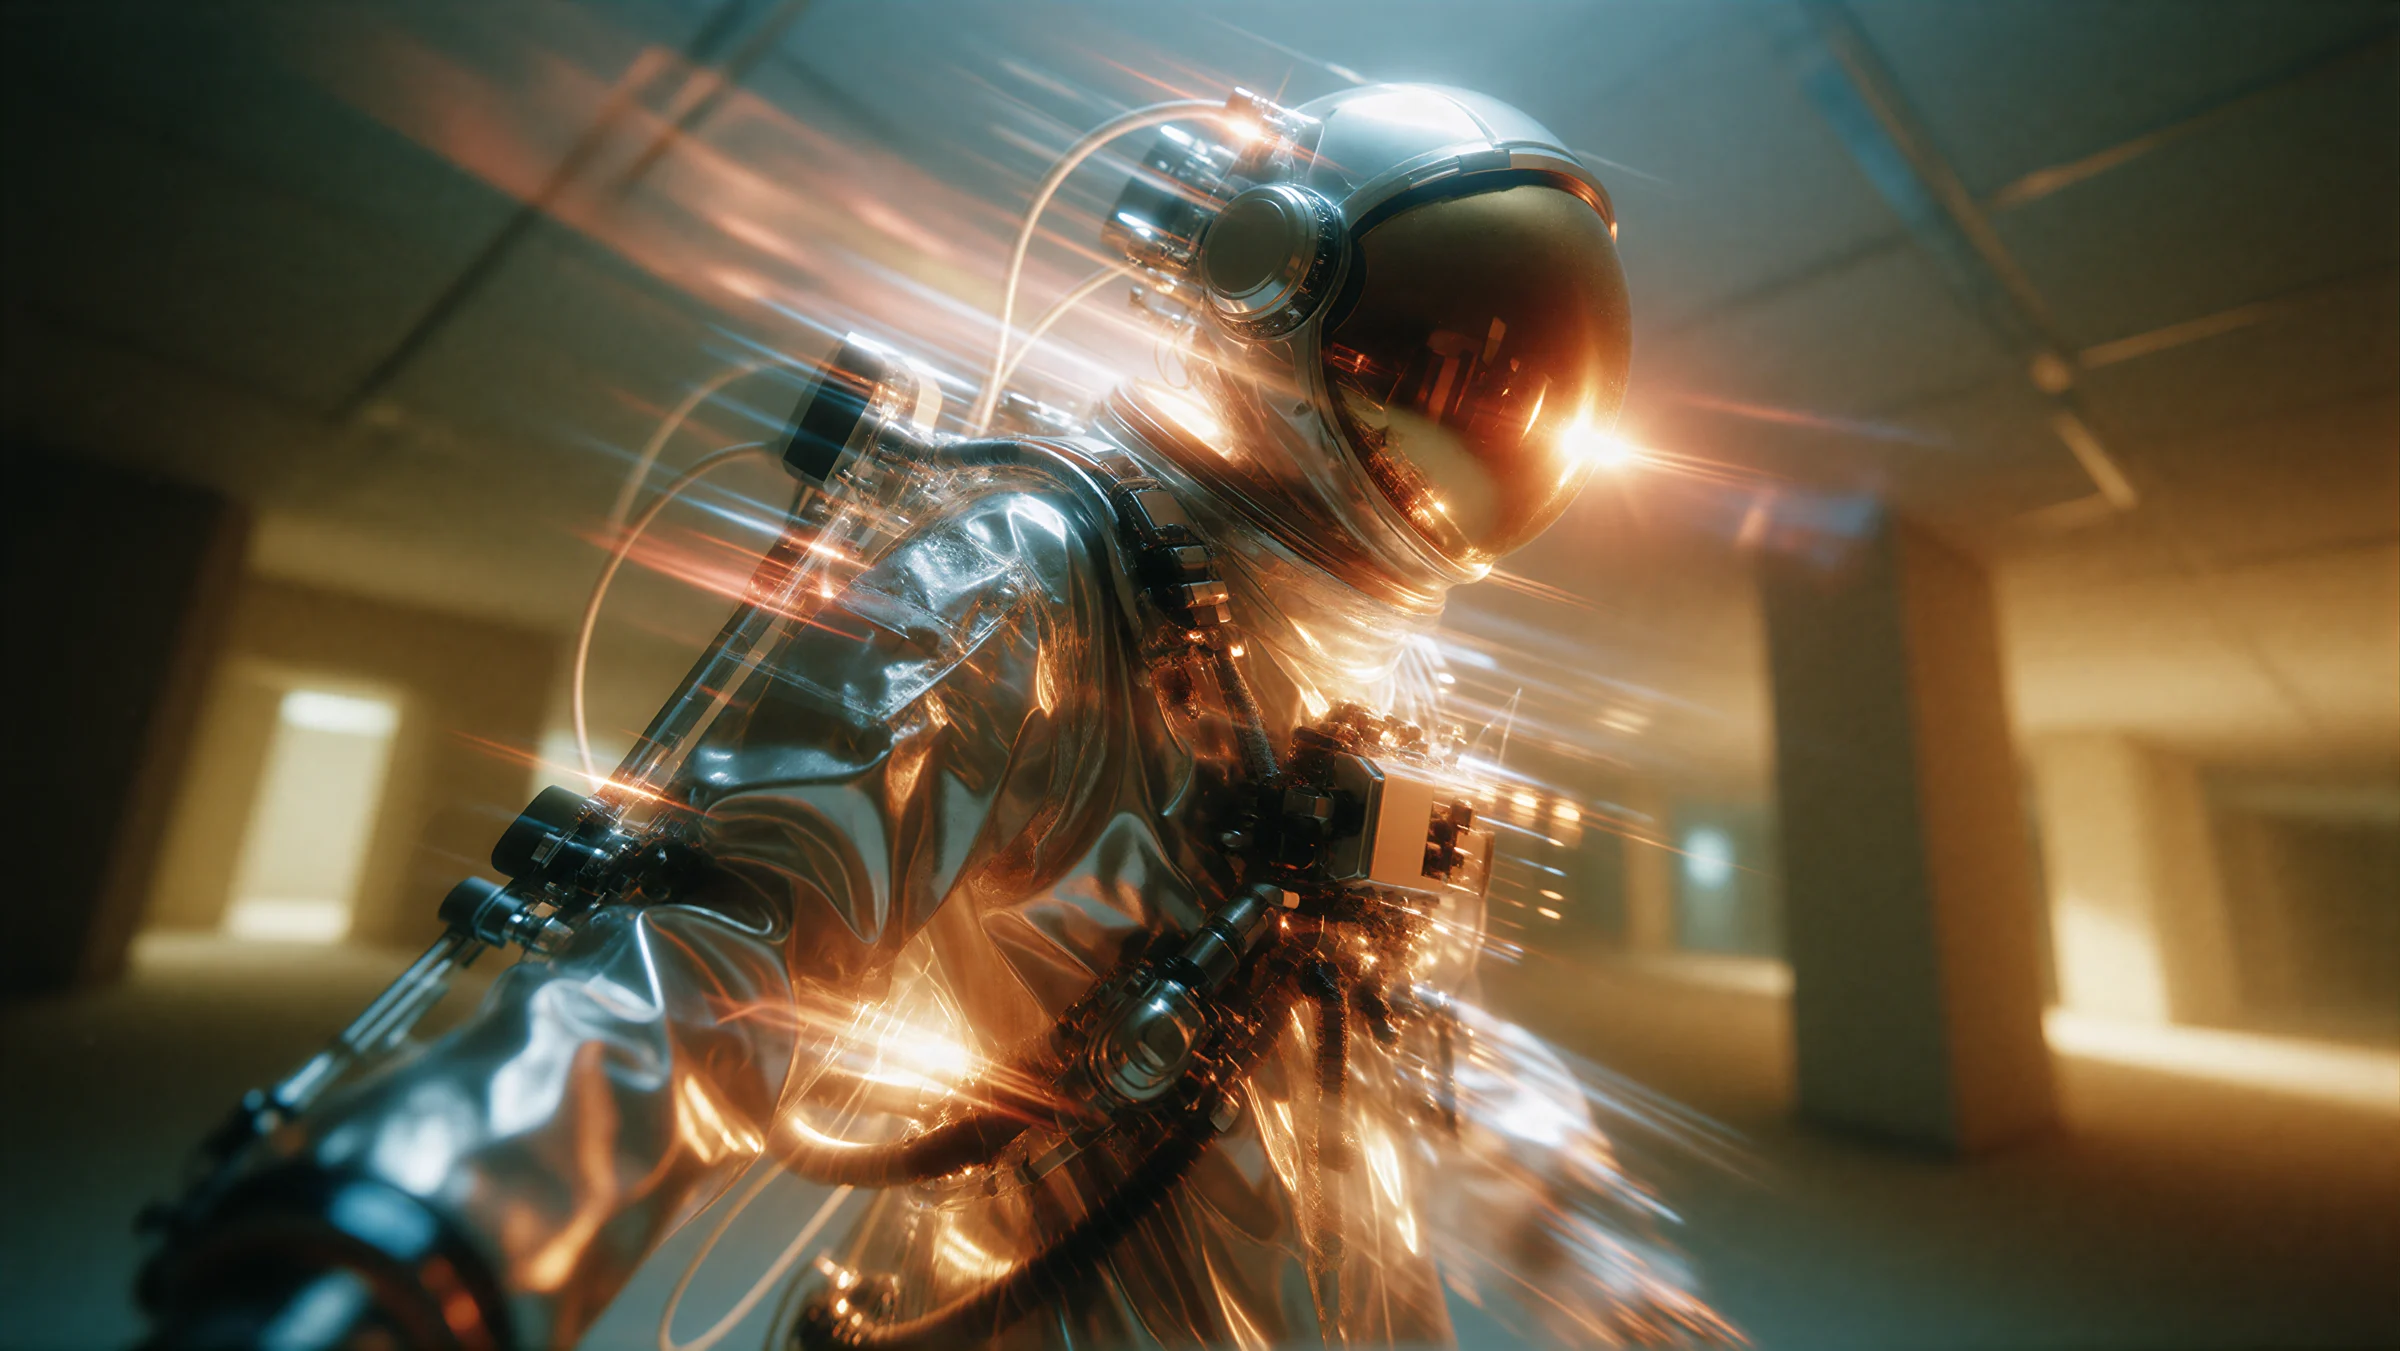
参考设定图由 Krea2 生成,用于指导剧情与视频整体风格;人物资产图约束头盔、服装、设备与轮廓。视频生成仅使用这两张图作为视觉参考。
参考设定图
银色材质、透明管线与琥珀光,建立整体影像的色彩、光感和空间气质。
KREA2 · VISUAL DIRECTION人物资产图
从面罩到背部维生装置,以同一份人物参考贯穿生成片段。
CHARACTER · IDENTITY REFERENCE从参考到音画,
在工作流中完成。
脚本在 Codex 中通过 Skill 自动生成。随后以本地 ComfyUI 工作流调用 MiniMax H3,将视觉参考与脚本转化为音画同步的片段。
- 01
确定视觉
Krea2 参考设定与人物资产,共同限定人物身份、材质、色彩和空间方向。
- 02
生成脚本
通过 Codex Skills 组织剧情、镜头动作、视觉约束与声音描述。
- 03
本地音画生成
将参考图与分段脚本交给 MiniMax H3,在 ComfyUI 中完成采样、音画解码与输出。
- 04
形成六段成片
每段 10–15 秒,按叙事顺序构成不超过 90 秒的作品,不做额外剪辑。
ComfyUI 工作流结构
依据本案例的 JSON 工作流整理,展示主要生成路径。
- 多参考输入人物 / 设定图 + 脚本
MiniMaxH3ReferenceToVideo - 第一轮采样构建音画内容
SamplerCustomAdvanced - 第二轮采样音画潜空间细化
PT_H3ConcatAVLatent - 音画输出解码 + 视频封装
MiniMaxH3AVDecodeT8
查看关键节点与配置
以下为所提供工作流的保存配置,不代表全部六段片段均使用完全相同的参数。
- 生成模型
- minimax_h3_fl2va_int8_convrot.safetensors
- 文本 / 视觉编码
- qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
- 视频与音频
- 独立视频 VAE、音频 VAE;MiniMaxH3AVDecodeT8 音画解码
- 采样
- Euler · Beta 调度 · 两轮采样
- 输出
- VHS_VideoCombine · H.264 · 24 fps
本地生成测试
保留一段约 5 秒的本地生成测试,用于核对画面与声音;完整参赛作品见「完整成片」章节。